
O que é BGP e como ele funciona no provedor de internet

Todo técnico de provedor chega no mesmo ponto: o ASN saiu, o bloco IP foi alocado, o contrato com a operadora de trânsito está assinado, e agora alguém precisa subir a sessão BGP. Se você está nessa fase, a pergunta certa antes de qualquer comando é o que é BGP de fato e o que ele faz com a sua rede. Sem essa base, a primeira configuração vira cópia de exemplo, e o primeiro erro vira incidente.
Este guia responde o que é BGP do ponto de vista de quem opera provedor e é a porta de entrada para os outros guias de BGP do blog. Ele explica AS e ASN, a diferença entre eBGP e iBGP, os atributos que decidem por onde o tráfego sai, o que são trânsito, peering e IX, e termina com uma primeira sessão comentada em Huawei VRP, que é o que eu uso na borda. Os endereços e ASNs dos exemplos são de documentação, então nada aqui aponta para uma rede real.
O que é BGP, em uma resposta rápida
BGP (Border Gateway Protocol) é o protocolo que as redes da internet usam para contar umas às outras quais blocos de IP cada uma alcança. Cada rede independente é um sistema autônomo (AS), identificado por um número, o ASN. O provedor anuncia os próprios blocos aos vizinhos e recebe deles as rotas para o resto da internet.
- Roda sobre TCP, na porta 179. Os vizinhos são configurados à mão; o BGP não descobre ninguém sozinho.
- É um protocolo de vetor de caminho: cada rota carrega a lista de ASNs por onde passou (o AS-path).
- Não escolhe pelo caminho mais rápido. Escolhe pela política que você configurou e, depois, por critérios como o AS-path mais curto.
- A versão em uso é o BGP-4, descrito na RFC 4271.
Uma forma simples de ver o que é BGP: o OSPF e o IS-IS cuidam do caminho dentro da sua rede. O BGP cuida da conversa com as outras redes, e nessa conversa vale mais o acordo comercial do que a distância.
AS e ASN: a identidade do provedor na internet
Não dá para explicar o que é BGP sem antes falar de AS. Um sistema autônomo é um conjunto de redes sob uma única administração e com uma política de roteamento própria. Na prática, é o seu provedor visto de fora. O ASN é o número que identifica esse conjunto em todas as tabelas BGP do mundo. Quem tem ASN próprio deixa de depender do bloco de IP de uma operadora e pode ter mais de um fornecedor de trânsito ao mesmo tempo.
No Brasil, ASN e blocos IP são distribuídos pelo Registro.br, que atua como registro nacional dentro da região do LACNIC. O pacote típico de quem está começando é o ASN, um bloco IPv4 pequeno (o /22 é um tamanho comum) e um bloco IPv6 bem maior. Se o IPv6 ainda é novidade para você, leia antes o que é IPv6: a sessão BGP de IPv6 segue a mesma lógica deste guia.
| Tipo | Faixa | Observação |
|---|---|---|
| ASN de 16 bits | 1 a 65534 | O formato original. Ainda é muito usado. |
| ASN de 32 bits | até 4294967295 | O formato atual (RFC 6793). Muitos provedores novos recebem um desses. |
| ASN privado | 64512 a 65534 e 4200000000 a 4294967294 | Uso interno, como um IP privado. Nunca deve aparecer na internet (RFC 6996). |
| ASN de documentação | 64496 a 64511 e 65536 a 65551 | Reservado para exemplos, como os deste guia (RFC 5398). |
Um detalhe que confunde no começo: o mesmo ASN aparece em todos os roteadores de borda do provedor. O AS é a organização, não o equipamento. Dois roteadores seus no mesmo AS conversam por iBGP; um roteador seu e um da operadora, por eBGP.
Como o BGP funciona por dentro
Para entender o que é BGP na prática, vale seguir a vida de uma sessão. Os dois roteadores abrem uma conexão TCP, trocam uma mensagem OPEN com o ASN e o router ID de cada lado e, se tudo bate, passam a trocar rotas em mensagens UPDATE. Depois disso só circulam mudanças: uma rota nova, uma rota retirada. A tabela inteira só é enviada de novo quando a sessão cai e volta, ou quando um lado pede um route refresh.
Entender o que é BGP também passa por saber como a sessão vigia o vizinho. Para saber se ele continua vivo, os dois lados mandam KEEPALIVE de tempos em tempos. No Huawei o padrão é 60 segundos de keepalive e 180 de hold time: se passar o hold time sem notícia do vizinho, a sessão cai e todas as rotas aprendidas dele saem da tabela. Quando um lado encontra um erro, ele manda NOTIFICATION e fecha a sessão.
Os estados da sessão
| Estado | O que está acontecendo |
|---|---|
| Idle | Sessão parada ou esperando para tentar de novo. |
| Connect / Active | Tentando abrir a conexão TCP na porta 179. Ficar preso em Active costuma ser IP errado, rota faltando ou filtro bloqueando a porta. |
| OpenSent / OpenConfirm | TCP aberto; os dois lados trocam a mensagem OPEN com ASN, router ID e tempos. Um ASN errado derruba a sessão aqui. |
| Established | Sessão no ar. Daqui em diante circulam as rotas (UPDATE) e os KEEPALIVE. |
Como o BGP evita loops
Cada AS que repassa uma rota acrescenta o próprio número no começo do AS-path. Se um roteador recebe uma rota que já tem o ASN dele no caminho, ele descarta essa rota. É por isso que o BGP não precisa de um cálculo de árvore como o OSPF: o próprio caminho carregado na rota denuncia o loop.
eBGP e iBGP: a mesma língua com regras diferentes
O protocolo é um só, mas o comportamento muda conforme o vizinho está ou não no mesmo AS. Essa diferença explica boa parte dos problemas de quem tem mais de um roteador de borda. Em entrevista de NOC, quem pergunta o que é BGP quase sempre chega nesse ponto.
| eBGP | iBGP | |
|---|---|---|
| Entre quem | ASNs diferentes (você e a operadora, você e o IX) | O mesmo ASN (seus roteadores) |
| Uso típico | Trocar rotas com o mundo | Espalhar as rotas externas dentro da sua rede |
| Vizinho | Normalmente diretamente conectado | Normalmente pela loopback, via IGP |
| AS-path | Seu ASN entra no caminho ao anunciar | Não muda |
| Next-hop | Passa a ser o seu roteador | Mantido, a menos que você mude |
| Repasse | Repassa para os outros vizinhos | Rota de iBGP não é repassada a outro vizinho iBGP |
A última linha da tabela é a que mais pega. Como o iBGP não repassa rota de um vizinho iBGP para outro, todos os roteadores BGP do AS precisam de sessão com todos (malha completa) ou de um route reflector que faça esse papel. A outra pegadinha é o next-hop: a rota chega no iBGP apontando para o IP da operadora, que o roteador interno não conhece. No Huawei isso se resolve com peer next-hop-local ou anunciando o enlace no IGP.
O iBGP também é a base das VPNs de camada 3 sobre MPLS. Se esse é o seu próximo passo, veja o guia de L3VPN MPLS no Huawei.
Atributos: como o BGP escolhe a melhor rota
Quando o mesmo prefixo chega por mais de um vizinho, o roteador escolhe um só caminho como melhor e só esse vai para a tabela de encaminhamento. A escolha segue uma lista fixa de critérios, avaliados em ordem. Quem entende essa lista entende o que é BGP como ferramenta de engenharia de tráfego.
| Atributo | Onde vale | Regra | Para que o provedor usa |
|---|---|---|---|
| local-preference | Dentro do seu AS | Maior vence. Padrão 100. | Escolher por qual trânsito o tráfego sai. |
| AS-path | Viaja com a rota | Mais curto vence. | Tornar um caminho menos atraente para quem chega (prepend). |
| origin | Viaja com a rota | IGP vence EGP, que vence incomplete. | Raramente mexido à mão. |
| MED | Enviado ao vizinho | Menor vence. Por padrão só compara rotas do mesmo AS. | Sugerir ao vizinho por qual de dois enlaces com ele entrar. |
| next-hop | Viaja com a rota | Precisa ser alcançável, senão a rota nem concorre. | Causa clássica de rota que aparece mas não é usada. |
| community | Viaja com a rota (se você mandar) | Não decide nada sozinha. | Etiqueta para acionar política no seu AS ou no vizinho. |
A ordem de decisão no Huawei, simplificada
- Rota com next-hop inalcançável é ignorada.
- Maior preferred value (PrefVal), um peso local da Huawei que não sai do roteador. Padrão 0.
- Maior local-preference.
- Rota originada no próprio roteador (por
networkou importação). - AS-path mais curto.
- Origin: IGP, depois EGP, depois incomplete.
- Menor MED.
- Rota de eBGP antes de rota de iBGP.
- Menor custo de IGP até o next-hop.
- Desempates finais, como o menor router ID.
Uma regra prática ajuda a lembrar: local-preference controla por onde o seu tráfego sai; AS-path prepend, MED e communities tentam influenciar por onde ele entra. Entrar é sempre mais difícil, porque a decisão final é do outro AS.
Trânsito, peering e IX
Só dá para responder o que é BGP por inteiro olhando os acordos por trás das sessões. Cada sessão do provedor tem um papel comercial, e esse papel define o que você recebe e o que pode anunciar.
| Tipo | Como funciona | O que você recebe |
|---|---|---|
| Trânsito IP | Pago. A operadora entrega rotas para a internet inteira e leva seus blocos para o mundo. | Tabela completa (perto de 1 milhão de prefixos IPv4) ou só a rota padrão |
| Peering bilateral | Acordo direto entre dois ASs, em geral sem custo de tráfego. | Só as redes do vizinho e dos clientes dele |
| IX (ponto de troca) | Uma porta conecta você a muitos ASs de uma vez, quase sempre por route server. | As redes de quem está no IX |
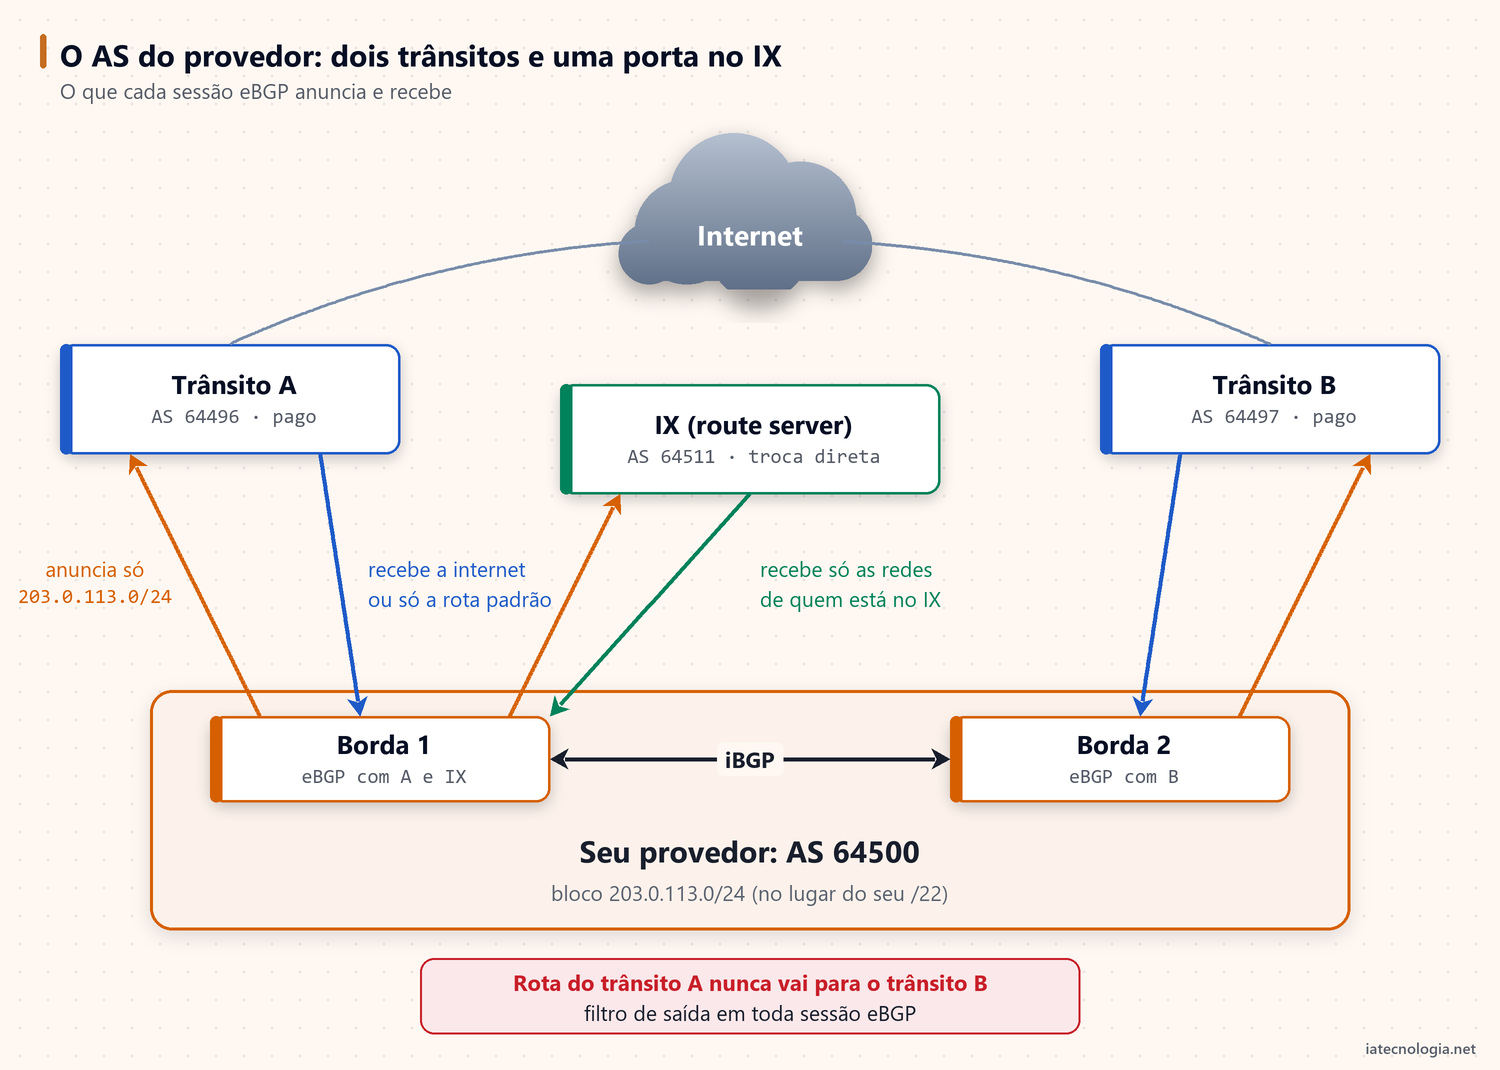
O desenho acima é o de muitos provedores regionais: dois trânsitos para ter redundância e uma porta no IX.br para trocar tráfego direto com conteúdo e outros provedores. No IX, a sessão com o route server entrega de uma vez as rotas de centenas de participantes, e o tráfego que sai por ali deixa de pagar trânsito.
A regra de ouro vale para os três casos: para trânsito, peering e IX você anuncia só os seus blocos e os dos seus clientes de trânsito, se tiver. Rota recebida de um trânsito nunca vai para o outro. Quando isso acontece, seu AS vira caminho entre duas operadoras grandes, o famoso vazamento de rotas.
Esse desenho tem uma armadilha. Com cada trânsito numa borda diferente, ele só é redundante de verdade se a Borda 1 souber sair pela Borda 2 e se a internet já conhecer o seu bloco pelo trânsito B no dia em que o A cair. Mostro o que precisa estar configurado mais abaixo, depois da primeira sessão, na seção sobre dois trânsitos em bordas diferentes.
Primeira sessão BGP no Huawei VRP
Saber o que é BGP ajuda pouco se a primeira configuração sai errada. O exemplo usa o AS 64500 com o bloco 203.0.113.0/24 no lugar do seu /22, e uma sessão de eBGP com o trânsito A (AS 64496, IP 198.51.100.1). A ordem importa: primeiro os filtros, depois a rota do bloco, por último a sessão. Se a CLI da Huawei ainda é nova para você, a lista de comandos para roteadores e switches Huawei ajuda com a navegação.
Passo 1: filtros de entrada e de saída
ip ip-prefix MEUS-BLOCOS index 10 permit 203.0.113.0 24
ip ip-prefix MEUS-QUALQUER index 10 permit 203.0.113.0 24 less-equal 32
route-policy SAIDA-TRANSITO permit node 10
 if-match ip-prefix MEUS-BLOCOS
 quit
route-policy SAIDA-TRANSITO deny node 100
 quit
route-policy ENTRADA-TRANSITO deny node 10
 if-match ip-prefix MEUS-QUALQUER
 quit
route-policy ENTRADA-TRANSITO permit node 100
 quit
commit
MEUS-BLOCOS casa exatamente o seu prefixo. MEUS-QUALQUER casa o prefixo e qualquer pedaço dele, até /32. A política SAIDA-TRANSITO deixa sair só o seu bloco e nega todo o resto no nó 100. A ENTRADA-TRANSITO recusa rotas para o seu próprio espaço vindas de fora e aceita o restante. No Huawei, uma rota que não casa com nenhum nó da route-policy é recusada; o nó 100 explícito deixa isso visível para quem ler a configuração depois.
Passo 2: a rota do bloco para o NULL0
ip route-static 203.0.113.0 255.255.255.0 NULL0
commit
O comando network do Huawei só anuncia um prefixo que existe na tabela de rotas com a mesma máscara. Os seus /24 ou /22 normalmente estão picados em sub-redes menores para clientes e servidores, então o agregado não existe. A estática para o NULL0 cria esse agregado. O tráfego para os pedaços em uso segue pelas rotas mais específicas; o que sobra, para um endereço sem dono, é descartado.
Passo 3: a sessão
bgp 64500
 router-id 203.0.113.1
 peer 198.51.100.1 as-number 64496
 peer 198.51.100.1 description TRANSITO-A
 ipv4-family unicast
  network 203.0.113.0 255.255.255.0
  peer 198.51.100.1 enable
  peer 198.51.100.1 route-policy ENTRADA-TRANSITO import
  peer 198.51.100.1 route-policy SAIDA-TRANSITO export
  quit
 quit
commit
Linha a linha: bgp 64500 abre o processo com o seu ASN. O router-id fixo evita que o roteador escolha um IP de interface que pode mudar. O peer ... as-number cria o vizinho e diz qual ASN você espera dele; se não bater com o que vem na mensagem OPEN, a sessão não sobe. A description é para quem ler a configuração às três da manhã.
Dentro de ipv4-family unicast, o network origina o seu bloco, o peer ... enable ativa a troca de rotas IPv4 com o vizinho e as duas route-policy aplicam os filtros do passo 1 na entrada (import) e na saída (export). Nos equipamentos que trabalham com confirmação em dois passos, nada vale antes do commit; em VRP sem esse modo, a linha passa a valer quando você aperta Enter.
Passo 4: conferir
display bgp peer
display bgp routing-table 203.0.113.0 24
display bgp routing-table peer 198.51.100.1 advertised-routes
O primeiro mostra o estado de cada vizinho. A saída esperada, com valores de exemplo, é parecida com esta:
 BGP local router ID : 203.0.113.1
 Local AS number : 64500
 Total number of peers : 1    Peers in established state : 1

  Peer          V    AS  MsgRcvd  MsgSent OutQ  Up/Down   State  PrefRcv
  198.51.100.1  4 64496   384217       38    0 00:31:12 Established 1012448
A coluna State precisa estar em Established e PrefRcv mostra quantos prefixos o vizinho mandou. O segundo comando confirma que o seu bloco está na tabela BGP como rota local. O terceiro é o mais importante no primeiro dia: ele lista o que você está anunciando para o trânsito. Ali só pode aparecer o seu bloco. Para quem ainda está fixando o que é BGP, esse é o teste que separa uma sessão saudável de um vazamento.
Dois trânsitos em bordas diferentes: o que acontece quando um cai
Este é o desenho do diagrama de trânsito, peering e IX: o trânsito A chega na Borda 1, o B na Borda 2, e um iBGP liga as duas. Parece redundância completa. Na prática, muitos provedores só descobrem que não é no dia em que a fibra do trânsito A rompe e os blocos param de navegar, mesmo com o trânsito B no ar.
Para entender o que falha, separe os dois sentidos do tráfego. A saída (o upload e as requisições dos clientes) é decidida por você, na tabela de rotas das bordas, no iBGP e no IGP. A entrada (o download, a resposta que volta) é decidida pelas outras redes, e elas só usam o trânsito B se o seu bloco já estiver anunciado lá. O failover precisa funcionar nos dois.
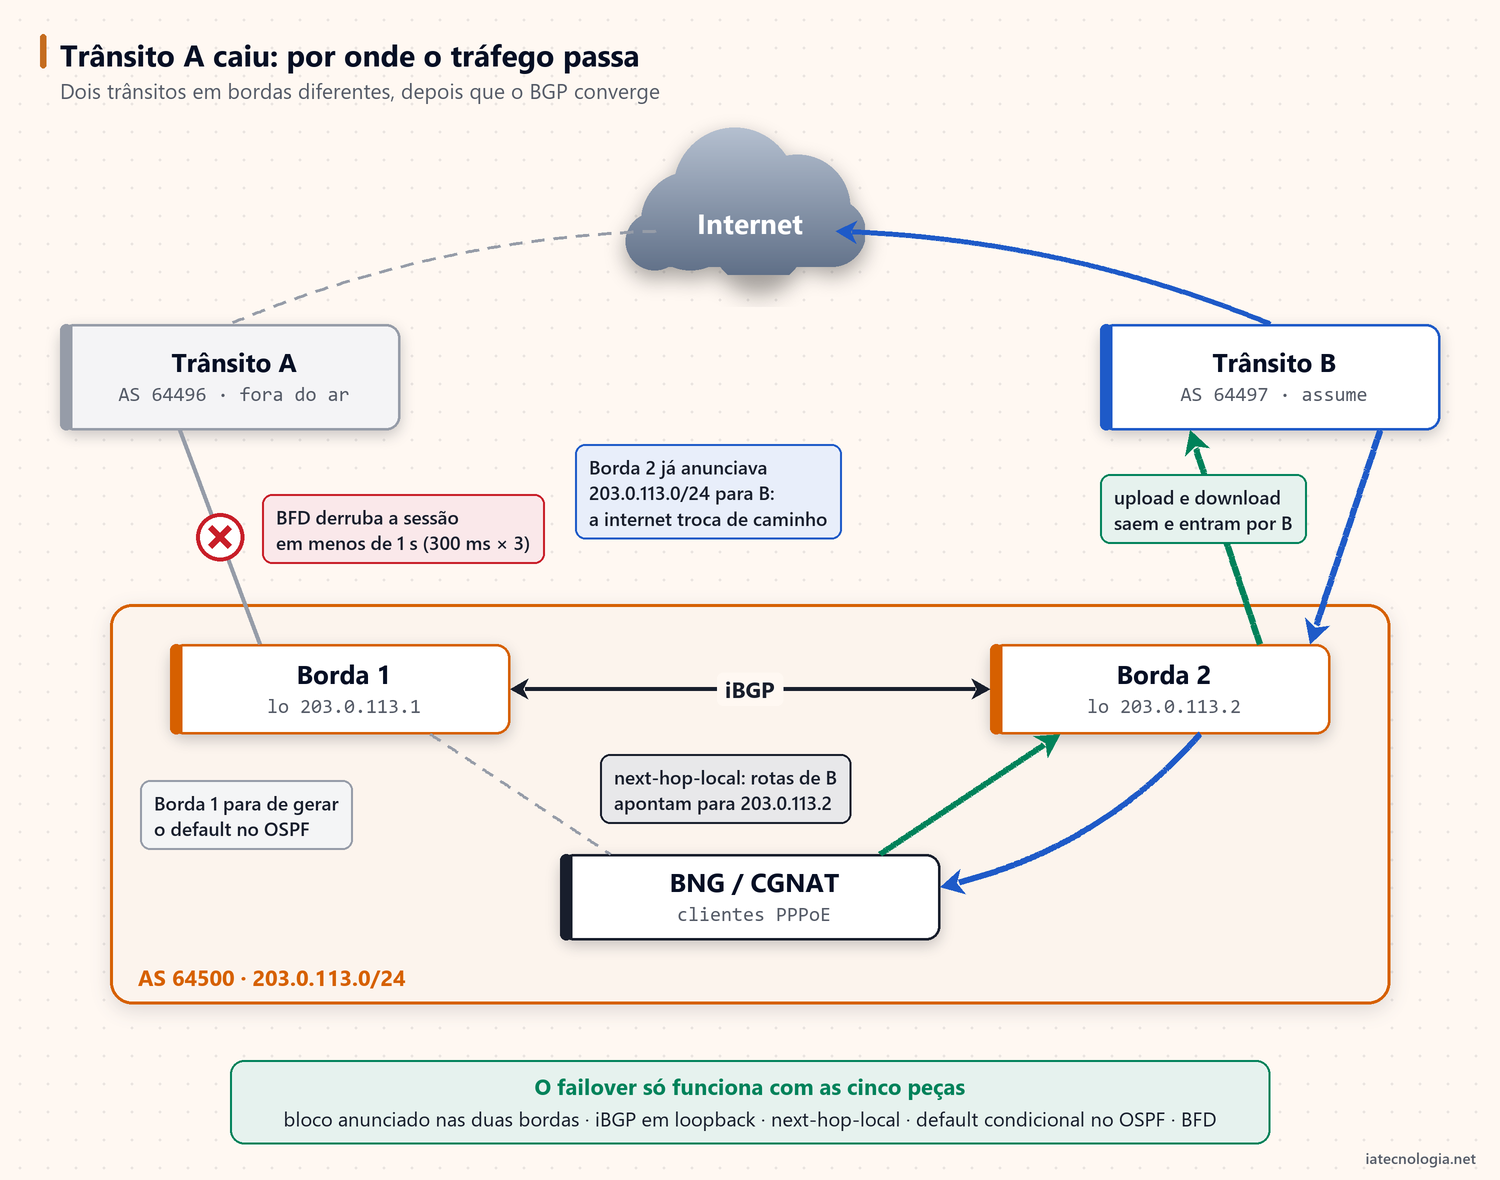
Os cinco motivos que derrubam o failover
| Problema | O que acontece quando A cai | Correção |
|---|---|---|
| Só a Borda 1 origina o bloco | O bloco some da internet: nada mais chega até você. | NULL0 e network também na Borda 2 |
| Rota de B chega na Borda 1 com next-hop 198.51.100.5 | A Borda 1 não alcança esse IP, a rota fica inválida e a Borda 1 não usa nada do que vem de B. | peer ... next-hop-local no iBGP |
| iBGP no IP do cabo entre as bordas, sem IGP | Cai o cabo, cai o iBGP, e cada borda fica sozinha. | iBGP entre loopbacks, com OSPF ou IS-IS |
| BNG ou CGNAT com rota padrão estática para a Borda 1 | O upload dos clientes continua indo para a borda sem trânsito. | Rota padrão no OSPF, gerada só por borda que tem saída |
| Sessão eBGP sem BFD | Se o enlace continua up, a sessão só cai depois do hold time: até 3 minutos. | BFD na sessão com cada trânsito |
O quinto ponto engana muita gente. No Huawei, o keepalive padrão é de 60 segundos e o hold time, de 180. Quando o trânsito chega por um transporte em camada 2, a porta da borda continua up mesmo com o outro lado morto, e a sessão BGP fica três minutos achando que está tudo bem. Nesse tempo, o tráfego que sai pela Borda 1 vai para um buraco negro.
Passo 1: loopback e IGP nas duas bordas
interface LoopBack0
 ip address 203.0.113.1 255.255.255.255
 quit
ospf 1 router-id 203.0.113.1
 area 0.0.0.0
  network 203.0.113.1 0.0.0.0
  network 192.0.2.0 0.0.0.3
  quit
 quit
commit
Esse é o bloco da Borda 1; na Borda 2, troque o IP da loopback por 203.0.113.2. A loopback não cai enquanto o roteador estiver ligado, e o OSPF leva o endereço dela pelos caminhos que existirem entre as bordas. Se houver um segundo caminho, pelo switch do núcleo ou pelo BNG, coloque esse enlace no OSPF também: é ele que mantém o iBGP de pé quando o cabo direto cai.
Passo 2: iBGP entre as loopbacks, na Borda 1
bgp 64500
 peer 203.0.113.2 as-number 64500
 peer 203.0.113.2 description BORDA-2
 peer 203.0.113.2 connect-interface LoopBack0
 ipv4-family unicast
  preference 100 200 200
  peer 203.0.113.2 enable
  peer 203.0.113.2 next-hop-local
  quit
 quit
commit
O connect-interface LoopBack0 faz a sessão sair e chegar pelas loopbacks. O next-hop-local resolve o problema mais comum desse desenho: sem ele, a rota que a Borda 2 aprendeu do trânsito B chega na Borda 1 com o next-hop 198.51.100.5, o IP do enlace de B, que a Borda 1 não alcança. Com ele, o next-hop passa a ser a loopback da Borda 2, que o OSPF conhece. Se a /32 da outra borda sumir do OSPF, o next-hop passa a resolver pela estática do bloco para o NULL0; por isso, use loopbacks de uma faixa de infraestrutura separada ou ligue BFD também no iBGP.
O preference 100 200 200 é uma pegadinha do Huawei. Por padrão, toda rota BGP tem preferência 255, pior que a rota externa do OSPF (150). Sem esse ajuste, uma rota padrão aprendida pelo OSPF da outra borda ganha da sessão eBGP com o seu próprio trânsito. Com 100 para eBGP e 200 para iBGP e rotas locais, a rota do seu trânsito vem primeiro, o OSPF externo em segundo e o iBGP por último. Não desça o eBGP para 20, como no Cisco: no Huawei a estática vale 60, e uma rota do trânsito passaria por cima da estática de um cliente com bloco próprio.
Repare também por que o filtro de saída da primeira sessão é obrigatório aqui. A Borda 2 aprende pelo iBGP a tabela inteira do trânsito A e, sem a SAIDA-TRANSITO, anunciaria tudo isso para o trânsito B. É exatamente o vazamento de rotas da regra de ouro.
Passo 3: a Borda 2 completa
ip route-static 203.0.113.0 255.255.255.0 NULL0
bgp 64500
 router-id 203.0.113.2
 peer 198.51.100.5 as-number 64497
 peer 198.51.100.5 description TRANSITO-B
 peer 203.0.113.1 as-number 64500
 peer 203.0.113.1 description BORDA-1
 peer 203.0.113.1 connect-interface LoopBack0
 ipv4-family unicast
  preference 100 200 200
  network 203.0.113.0 255.255.255.0
  peer 198.51.100.5 enable
  peer 198.51.100.5 route-policy ENTRADA-TRANSITO import
  peer 198.51.100.5 route-policy SAIDA-TRANSITO export
  peer 203.0.113.1 enable
  peer 203.0.113.1 next-hop-local
  quit
 quit
commit
Antes desse bloco, crie na Borda 2 os mesmos filtros do passo 1 da primeira sessão, com os mesmos nomes. O ponto central é que a Borda 2 também origina o bloco, com a própria estática para o NULL0 e o próprio network. Assim o trânsito B recebe o seu prefixo o tempo todo, e não só quando o A cai. A internet já conhece os dois caminhos e só precisa descartar um deles.
Passo 4: BFD nas sessões com os trânsitos
bfd
 quit
bgp 64500
 peer 198.51.100.1 bfd enable
 quit
commit
O bfd sozinho liga o recurso no equipamento; o peer ... bfd enable amarra o BFD à sessão com o trânsito A. Na Borda 2, repita com o peer 198.51.100.5. O intervalo padrão muda conforme o modelo: 10 ms nos NE e CE, 1 segundo nos AR e S. Para fixar, acrescente peer 198.51.100.1 bfd min-tx-interval 300 min-rx-interval 300 detect-multiplier 3, que detecta a queda em menos de um segundo.
O BFD precisa estar ligado dos dois lados, então combine com a operadora. Se ela não oferecer, encurte os temporizadores com peer 198.51.100.1 timer keepalive 10 hold 30. O hold time negociado é o menor dos dois lados, então vale só do seu lado, mas a mudança derruba a sessão: faça na janela de manutenção e avise a operadora.
Passo 5: rota padrão no OSPF para o BNG
ospf 1
 default-route-advertise cost 10 type 1
 quit
commit
Esse é o bloco da Borda 1; na Borda 2, use cost 20. Sem a palavra always, a borda só gera a rota padrão no OSPF enquanto tiver uma rota padrão ativa vinda de outro protocolo, aqui a do trânsito. Peça às operadoras a tabela completa mais a rota padrão, ou só a rota padrão. No BNG ou no CGNAT, troque a estática por OSPF: ele aprende as duas rotas padrão e usa a de menor custo. O BGP decide nas bordas, mas o BNG precisa de um protocolo interno para saber qual borda está viva.
Quando o trânsito A cai, a melhor rota padrão da Borda 1 passa a ser a do OSPF, vinda da Borda 2. Como ela não gera de novo uma rota que aprendeu do próprio OSPF, para de anunciá-la, e o BNG fica só com a da Borda 2. O upload troca de caminho sem ninguém mexer em nada.
Escolher o trânsito principal (opcional)
Sem política nenhuma, cada borda escolhe rota a rota: vence o AS-path mais curto e, só no empate, a rota de eBGP ganha da de iBGP. Com tabela completa, parte do tráfego da Borda 1 já sai pela Borda 2. Para usar o A como principal e o B como reserva na saída, suba a local-preference de tudo o que vem do A. Esse bloco vai na Borda 1:
route-policy ENTRADA-TRANSITO-A deny node 10
 if-match ip-prefix MEUS-QUALQUER
 quit
route-policy ENTRADA-TRANSITO-A permit node 100
 apply local-preference 200
 quit
bgp 64500
 ipv4-family unicast
  peer 198.51.100.1 route-policy ENTRADA-TRANSITO-A import
  quit
 quit
commit
A local-preference vale para o AS inteiro: a Borda 2 passa a preferir as rotas do A, aprendidas pelo iBGP, e manda o tráfego pela Borda 1. Na entrada, o recurso mais simples é deixar o caminho por B mais longo com AS-path prepend. Esse bloco vai na Borda 2:
route-policy SAIDA-TRANSITO-B permit node 10
 if-match ip-prefix MEUS-BLOCOS
 apply as-path 64500 64500 additive
 quit
route-policy SAIDA-TRANSITO-B deny node 100
 quit
bgp 64500
 ipv4-family unicast
  peer 198.51.100.5 route-policy SAIDA-TRANSITO-B export
  quit
 quit
commit
Quando o A cai, o caminho com prepend vira o único e a internet passa a usá-lo. O prepend não é garantia: muitas redes preferem rotas de cliente por local-preference e ignoram o tamanho do AS-path. Para controle fino, use as communities das operadoras, como mostro em BGP communities no Huawei, com o sistema completo de engenharia de tráfego.
Com o /22 real: agregado nos dois trânsitos
Aqui entra o planejamento de endereços. No exemplo, o /24 não dá para dividir, porque prefixo mais específico que /24 é filtrado na internet. Com o seu /22, a prática comum é anunciar o /22 nos dois trânsitos e um /23 em cada um para dividir a entrada. Quando o A cai, o /23 dele some e o /22 que está no B cobre. Cada prefixo precisa da própria estática para o NULL0, do registro no IRR e de um ROA que cubra o tamanho anunciado.
O erro clássico é anunciar cada pedaço num trânsito só e o agregado em nenhum. Quando o A cai, os pedaços que estavam nele somem da internet, e são justamente esses blocos que param de navegar.
Teste de failover na janela de manutenção
Redundância que nunca foi testada é só uma hipótese. Numa janela combinada, derrube a sessão com o trânsito A na Borda 1 e confira para onde a rota padrão foi:
bgp 64500
 peer 198.51.100.1 ignore
 quit
commit
display bgp routing-table 0.0.0.0 0
display ip routing-table 0.0.0.0 0
O peer ... ignore derruba a sessão sem apagar a configuração. A saída esperada, com valores de exemplo, mostra a rota padrão vindo do OSPF, com next-hop na Borda 2:
Route Flags: R - relay, D - download to fib
-----------------------------------------------------------------------
Routing Table : _public_
Summary Count : 1
Destination/Mask  Proto  Pre  Cost  Flags NextHop       Interface
      0.0.0.0/0   O_ASE  150  21      D   192.0.2.2     GE0/0/1
Na Borda 2, confira as sessões, o que está saindo para o trânsito B (só o seu bloco) e se a rota padrão da Borda 1 sumiu da base do OSPF:
display bgp peer
display bgp routing-table peer 198.51.100.5 advertised-routes
display ospf lsdb ase
Por fora, confirme num looking glass de uma operadora grande ou no bgp.tools que o caminho para o seu bloco agora passa pelo AS 64497, e faça um traceroute a partir de um cliente. Terminado o teste, volte a sessão:
bgp 64500
 undo peer 198.51.100.1 ignore
 quit
commit
Com a tabela completa, a volta leva alguns minutos até o trânsito A mandar todas as rotas de novo. Teste também a falha que o BFD não pega: a sessão no ar e o trânsito sem tráfego por um problema dentro da operadora. Esse caso só aparece no monitoramento, e a saída é o mesmo peer ... ignore, feito à mão.
Erros comuns de quem acabou de aprender o que é BGP
- Subir a sessão sem filtro de saída. Sem
export, o roteador pode repassar ao trânsito B tudo o que aprendeu do trânsito A. É o caminho mais curto para um vazamento de rotas. - Anunciar com
networke esquecer a rota do agregado. O comando entra sem erro, mas nada é anunciado. Confira comadvertised-routes. - Sessão parada em Active. Quase sempre é o básico: IP do vizinho digitado errado, interface sem o IP do enlace ou um filtro bloqueando o TCP 179.
- ASN trocado no
as-number. A conexão TCP abre, a sessão cai logo depois e o log mostra erro de OPEN. Confira o ASN que a operadora informou. - Achar que dois trânsitos em bordas diferentes já são redundância. Sem o bloco anunciado nas duas bordas, iBGP em loopback com
next-hop-locale rota padrão condicional no IGP, a queda de um trânsito derruba os blocos do provedor. - Não cadastrar o bloco onde as operadoras conferem. Muitas operadoras filtram o que aceitam pelos registros de roteamento (IRR) e pelo RPKI. Prefixo sem registro pode simplesmente não ser aceito.
Perguntas frequentes
O que é BGP e para que ele serve?
É o protocolo que as redes usam para trocar rotas entre si na internet. Ele permite que o provedor anuncie os próprios blocos de IP e receba das operadoras as rotas para o resto do mundo, aplicando a política que ele definir.
Preciso de ASN próprio para usar BGP?
Para ter mais de um trânsito e anunciar seus blocos para o mundo, sim. Dentro da própria rede dá para usar ASN privado, mas ele nunca deve ser anunciado para a internet.
Qual a diferença entre eBGP e iBGP?
O eBGP liga ASs diferentes, como o seu e o da operadora. O iBGP liga roteadores do mesmo AS e espalha as rotas externas dentro da rede. As regras de AS-path, next-hop e repasse mudam entre os dois.
Por que o BGP não escolhe o caminho mais rápido?
Porque ele não mede velocidade nem latência. A escolha segue os atributos em ordem, a começar pela política local. Se você quer que um caminho seja o preferido, precisa dizer isso com local-preference ou outro atributo.
Posso receber só a rota padrão em vez da tabela completa?
Pode, e para roteadores com pouca memória costuma ser a melhor escolha. Muita gente que ainda está entendendo o que é BGP começa assim. Com dois trânsitos e só a rota padrão de cada um, você perde a escolha fina de caminho, mas mantém a redundância.
Tenho dois trânsitos em roteadores diferentes. O que garante o failover?
Cinco coisas: as duas bordas originam o bloco, o iBGP entre elas usa as loopbacks com next-hop-local, o IGP leva essas loopbacks, cada borda gera a rota padrão no OSPF só quando tem saída, e o BFD derruba rápido a sessão com o trânsito que caiu. Nenhuma delas é avançada; o problema é esquecer uma. Depois, teste numa janela de manutenção.
Quanto tempo leva para a sessão BGP subir?
Com tudo certo, a sessão fica Established em poucos segundos. Receber a tabela completa leva mais, de alguns segundos a poucos minutos, conforme o equipamento. Se passar disso parado em Active, revise IP, ASN e filtros.
Conclusão
Entender o que é BGP é entender que ele é um protocolo de política: você decide o que anuncia, o que aceita e por onde prefere sair, e o protocolo leva essas decisões para as outras redes. AS e ASN são a sua identidade, eBGP e iBGP são as duas formas de conversa, e os atributos são as alavancas. A primeira sessão é curta; o que dá trabalho, e evita incidente, são os filtros.
Com a sessão no ar e os filtros conferidos, o passo seguinte é organizar a engenharia de tráfego. O guia de BGP communities no Huawei, com o sistema completo de engenharia de tráfego parte exatamente daqui, já supondo que você sabe o que é BGP e tem uma sessão estável.
Leitura recomendada: Fundamentos do BGP, na wiki do Brasil Peering Forum (CC BY-NC 4.0).

6 Comentários
Deixe um comentário
Leia Também
 BGP
AS-override e allowas-in no BGP: diferença e quando usar
AS-override e allowas-in no BGP: por que o CE descarta a rota do outro site, qual lado corrige o loop e a sintaxe em Cisco, Huawei e Junos.
 BGP
IX.br: como conectar seu provedor ao ponto de troca de tráfego
IX.br para provedor com ASN: requisitos, adesão no meu.ix.br, route servers, PeeringDB, regras da porta e a configuração BGP no Huawei.
 BGP
BGP no Mikrotik RouterOS v7: connection, templates e filtros
BGP no Mikrotik RouterOS v7 com dois trânsitos: instance, template, connection, anúncio por address-list, filtros na sintaxe nova e verificação.
[…] O preço é claro: o IP atacado fica fora do ar enquanto o bloqueio durar. Em troca, o resto do bloco continua navegando. Este guia explica quando vale usar RTBH, como funcionam as communities de blackhole, a configuração completa no Huawei VRP e os cuidados para não vazar um /32 nem esquecer um bloqueio ativo por semanas. Os exemplos usam endereços e ASNs de documentação. Se sessão eBGP, AS-path e prefixo ainda são novidade, leia antes o guia o que é BGP e como ele funciona. […]
[…] Quem recebe o primeiro ASN e o primeiro bloco do Registro.br costuma deixar o RPKI para depois. A sessão BGP sobe, o prefixo aparece na internet e tudo parece resolvido. O problema é que, sem uma ROA publicada, nada impede que outro AS anuncie o seu bloco e leve parte do tráfego dos seus clientes. E muitos trânsitos e IXs descartam rotas inválidas, então a ROA errada também derruba o seu próprio anúncio. Se a sessão BGP ainda é novidade, veja antes o que é BGP e como ele funciona no provedor. […]
[…] Este guia monta uma borda com dois trânsitos do zero, na sintaxe atual. O AS 64500 anuncia 203.0.113.0/24, o trânsito A (AS 64501) é o preferido e o trânsito B (AS 64502) fica de reserva. Todos os endereços e ASNs são de documentação, e os comandos foram conferidos na documentação oficial da MikroTik. Se o conceito de AS, eBGP e atributos ainda é novo para você, comece por o que é BGP e como ele funciona. […]
[…] O peering não substitui o trânsito: pelo IX você alcança só as redes dos participantes. Para revisar a base, veja o que é BGP e como ele funciona. […]
[…] sistemas autônomos sem precisar de nenhum outro mecanismo. Se isso ainda é novo, o guia sobre o que é BGP e como ele funciona explica a […]
[…] iBGP e, mais tarde, os LSPs do MPLS. Se você precisa revisar o papel de cada protocolo, veja como o BGP funciona e o que é MPLS. O OSPF no provedor não precisa saber onde está o cliente; precisa saber onde […]