
OSPF no provedor: boas práticas de áreas, custo e loopback

O OSPF no provedor costuma nascer pequeno e crescer sem plano. Começa com dois roteadores, para poupar umas rotas estáticas, e alguns anos depois carrega pool de PPPoE, rede de cliente dedicado, prefixo redistribuído do BGP e meia dúzia de áreas criadas por costume. Quando um enlace oscila, todo mundo recalcula, e ninguém sabe dizer por que o tráfego foi para o caminho errado.
Este guia defende um IGP enxuto: o OSPF carrega só as loopbacks e os enlaces entre os seus roteadores, e o resto fica com o BGP. Mostro como fazer isso em Huawei (VRP8, NE8000 e NE40E) e em Mikrotik RouterOS v7, com router-id na loopback, banda de referência, custo, interfaces passivas, autenticação, rede ponto a ponto em Ethernet e BFD. O cenário é um anel de quatro roteadores, com endereços de documentação.
Resposta rápida: o checklist do OSPF no provedor
- No OSPF entram as loopbacks /32 e os enlaces entre roteadores. Pool de cliente, CGNAT e tabela de trânsito ficam no BGP.
- Comece com uma área só, a área 0. Dividir em áreas é decisão de escala, não de organização.
- Fixe o router-id com o IP da loopback. Nunca deixe o roteador escolher.
- Ajuste a banda de referência igual em todos os equipamentos, ou defina o custo à mão em cada enlace.
- Use network-type p2p nos enlaces Ethernet entre dois roteadores. Não há DR para eleger.
- Interface que precisa ter a rede anunciada, mas não deve formar vizinhança, fica passiva (silent-interface no Huawei, passive no Mikrotik).
- Ative autenticação e BFD nos enlaces de backbone.
O que entra no OSPF no provedor e o que fica fora
O papel do IGP num provedor é um só: dizer a cada roteador como chegar à loopback dos outros. É sobre essas loopbacks que sobem as sessões iBGP e, mais tarde, os LSPs do MPLS. Se você precisa revisar o papel de cada protocolo, veja como o BGP funciona e o que é MPLS. O OSPF no provedor não precisa saber onde está o cliente; precisa saber onde está o roteador que atende o cliente.
Quando o pool de PPPoE entra no OSPF, cada cliente que conecta e desconecta pode virar mudança na base de estados de enlace. Rede /30 de cliente dedicado, rota estática redistribuída e rotas do BGP importadas no IGP pioram o quadro: a base cresce, o SPF roda mais vezes e um erro de configuração num POP se espalha pela rede inteira. Os prefixos de cliente ficam no BGP, anunciados pelo roteador que os atende, com next-hop na loopback dele.
| Entra no OSPF | Fica fora do OSPF |
|---|---|
| Loopback /32 de cada roteador | Pools de PPPoE, IPoE e CGNAT |
| Enlaces /30 ou /31 entre roteadores | Redes de clientes dedicados |
| Rede de gerência do POP (como passiva) | Tabela completa e rotas recebidas de trânsito |
| Nada mais, na maioria dos casos | Rotas estáticas redistribuídas por conveniência |
A rede de gerência é a exceção que costumo aceitar: ela é pequena, muda pouco e precisa ser alcançada mesmo quando o BGP está fora. Ainda assim, entra como interface passiva, sem formar vizinhança com ninguém que esteja naquela rede.
Área 0 e quando dividir em áreas
Muito material sobre OSPF ensina áreas logo no começo, e isso leva a backbone de dez roteadores dividido em três áreas. Áreas existem para limitar o tamanho da base de estados de enlace e o alcance do SPF em redes grandes. Para o OSPF no provedor regional, com algumas dezenas de roteadores, uma área 0 só funciona bem e é muito mais fácil de depurar.
Cada área nova traz roteadores de borda de área (ABR), sumarização para planejar e regras sobre o que pode passar de uma área para outra. Se a sumarização estiver errada, uma loopback some e o iBGP cai sem aviso claro. Divida quando houver motivo medido: base de estados de enlace grande demais para os equipamentos menores, ou uma região inteira com enlaces instáveis que você quer isolar do resto.
Antes de dividir, vale olhar para o IS-IS, que muitos provedores preferem no backbone. Escrevi sobre ele em IS-IS no Huawei para backbone. Os princípios deste guia (IGP enxuto, loopback, custo planejado) valem para os dois.
Router-id na loopback: configuração no Huawei
No OSPF no provedor, o router-id identifica cada roteador. Se você não define, o VRP escolhe um endereço de interface, e trocar esse endereço depois exige reiniciar o processo. A regra prática é usar o IP da LoopBack0, uma /32 que não cai com nenhum enlace. É o mesmo endereço que será o LSR ID do MPLS e a origem das sessões iBGP.
system-view
interface LoopBack0
 description ROUTER-ID
 ip address 198.51.100.1 255.255.255.255
 quit
ospf 1 router-id 198.51.100.1
 bandwidth-reference 100000
 area 0.0.0.0
  quit
 quit
interface LoopBack0
 ospf enable 1 area 0.0.0.0
 quit
commit
interface LoopBack0eip address ... 255.255.255.255: a loopback é /32. É o endereço que o LDP e o iBGP vão usar, e padronizar a máscara evita surpresa com a FEC do LDP e com outros IGPs.ospf 1 router-id: fixa o router-id com o IP da loopback.bandwidth-reference 100000: referência de 100 Gbit/s para o cálculo do custo, explicada na próxima seção.area 0.0.0.0: cria a área 0 dentro do processo.ospf enable 1 area 0.0.0.0na loopback: coloca a /32 no OSPF. Prefiro ativar na interface em vez de usarnetwork, porque quem lê a interface já sabe que ela está no IGP.commit: no VRP8 nada vale antes dele. Nos switches com VRP5, como o S6730, os mesmos comandos entram na hora e não existecommit.
Banda de referência e custo dos enlaces
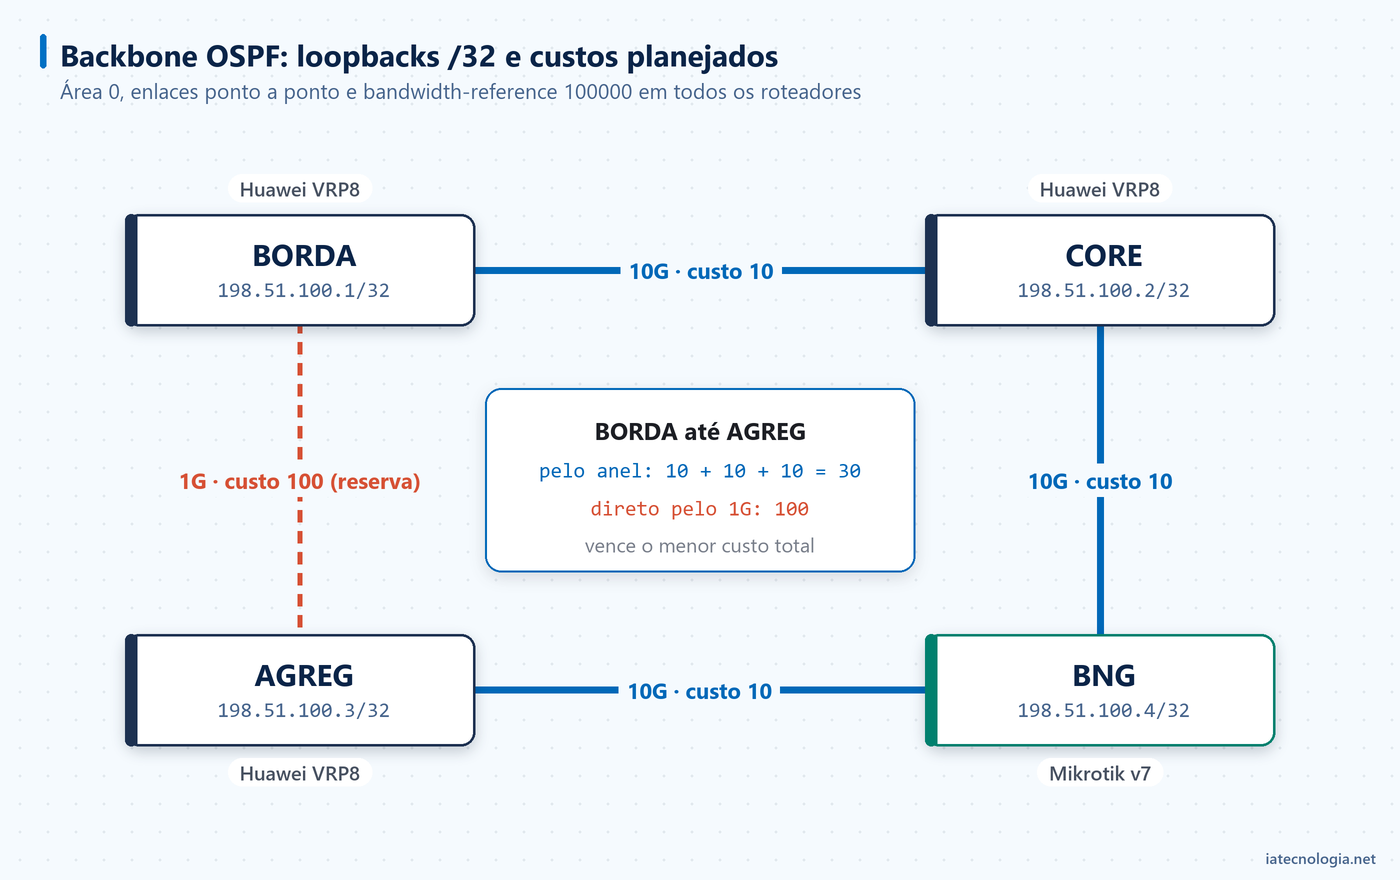
O OSPF escolhe o caminho pela soma dos custos. O custo de cada interface vem da conta referência dividida pela banda, e a referência padrão do Huawei é 100 Mbit/s. Com esse padrão, uma porta de 1G e uma de 10G ficam com custo 1, e o roteador acha que são iguais. Um enlace de reserva de 1G pode passar a carregar o tráfego do de 10G sem que ninguém perceba.
Com bandwidth-reference 100000, a referência passa a 100 Gbit/s: 10G fica com custo 10 e 1G com custo 100. No OSPF no provedor, o valor tem de ser o mesmo em todos os roteadores, senão cada um calcula o custo de um jeito e o caminho de ida difere do de volta. No Mikrotik RouterOS v7 não existe essa conta automática: o custo é o que você põe no interface-template.
Por isso eu prefiro custo explícito nos enlaces que importam, principalmente nos de reserva. No cenário, o enlace de 1G entre AGREG e BORDA recebe ospf cost 100 mesmo que a conta já desse 100. Se alguém trocar a porta por uma de 10G, o enlace continua sendo reserva até alguém decidir o contrário.
| Banda do enlace | Custo com referência 100 Mbit/s | Custo com referência 100 Gbit/s |
|---|---|---|
| 1 Gbit/s | 1 | 100 |
| 10 Gbit/s | 1 | 10 |
| 40 Gbit/s | 1 | 2 |
| 100 Gbit/s | 1 | 1 |
Enlaces ponto a ponto em Ethernet
Uma interface Ethernet é tratada como broadcast pelo OSPF, mesmo quando só há dois roteadores no cabo. Isso significa eleição de DR e BDR, uma espera a mais para a adjacência fechar e um LSA de rede que não serve para nada. Em enlace de backbone, use o tipo ponto a ponto nas duas pontas.
interface GigabitEthernet0/1/0
 description BB-CORE
 ip address 203.0.113.1 255.255.255.252
 ospf network-type p2p
 ospf enable 1 area 0.0.0.0
 quit
interface GigabitEthernet0/1/1
 description BB-AGREG
 ip address 203.0.113.14 255.255.255.252
 ospf network-type p2p
 ospf cost 100
 ospf enable 1 area 0.0.0.0
 quit
commit
O ospf network-type p2p tem de estar nos dois lados. Com tipos diferentes, a vizinhança pode até chegar a Full, mas as rotas pelo enlace ficam faltando. O description com o nome do vizinho parece detalhe, mas é ele que salva a madrugada de quem está no plantão. No RouterOS v7, o equivalente é type=ptp no interface-template, que aparece mais adiante.
Interfaces passivas e rede de gerência
Interface passiva é a que tem a rede anunciada no OSPF, mas não envia nem recebe pacotes do protocolo. Serve para a rede de gerência do POP, onde ficam switch, OLT e rádio: o resto do backbone precisa alcançá-la, mas nenhum equipamento ali deveria formar vizinhança com o roteador. Sem isso, qualquer coisa ligada naquela VLAN que fale OSPF pode injetar rotas e bagunçar o backbone inteiro, algo que o OSPF no provedor não pode aceitar.
interface GigabitEthernet0/1/2
 description GERENCIA-POP
 ip address 192.0.2.1 255.255.255.0
 ospf enable 1 area 0.0.0.0
 quit
ospf 1
 silent-interface GigabitEthernet0/1/2
 quit
commit
No Huawei, silent-interface vai dentro do processo e aceita o nome da interface ou all. Com silent-interface all e depois undo silent-interface nas interfaces de backbone, você inverte a lógica: tudo começa passivo. Cuidado com a ordem, porque rodar o all depois apaga os undo já configurados. A loopback não precisa disso, porque não forma vizinhança.
Autenticação e BFD nos enlaces de backbone
Autenticação no OSPF no provedor não é sobre sigilo, é sobre não aceitar vizinho por engano. Um técnico que liga um roteador de teste no lugar errado, ou um cliente com OSPF ativo numa porta que devia ser só acesso, não forma adjacência se a chave não bater. Entre Huawei, uso HMAC-SHA256; no enlace com o Mikrotik, MD5, que os dois lados aceitam com a mesma key-id.
interface GigabitEthernet0/1/0
 ospf authentication-mode hmac-sha256 1 cipher Troque-Esta-Chave
 quit
interface GigabitEthernet0/1/1
 ospf authentication-mode md5 1 cipher Troque-Esta-Chave
 quit
commit
A key-id (1) e a chave precisam ser iguais nas duas pontas. O cipher faz o VRP guardar a senha cifrada na configuração. Troque a chave do exemplo; e, ao mudar a autenticação de um enlace em produção, lembre que a vizinhança cai até as duas pontas terem a mesma configuração.
BFD para detectar a queda em milissegundos
Sem BFD, o OSPF percebe a queda de um vizinho pelo dead interval, de 40 segundos por padrão. Se a porta física cai, o roteador percebe na hora. O problema são os casos em que a porta continua de pé: conversor de mídia, rádio no meio do caminho ou switch de transporte. O BFD troca pacotes pequenos em intervalos curtos e avisa o OSPF assim que eles param de chegar.
bfd
 quit
interface GigabitEthernet0/1/0
 ospf bfd enable
 quit
interface GigabitEthernet0/1/1
 ospf bfd enable
 quit
commit
O bfd sozinho habilita o recurso no equipamento; ospf bfd enable liga o BFD para as vizinhanças daquela interface. As duas pontas precisam estar configuradas, senão a sessão BFD não sobe. Comece com os intervalos padrão da versão e confira com display ospf bfd session all antes de pensar em reduzi-los.
A mesma configuração no Mikrotik RouterOS v7
No RouterOS v7, o OSPF foi reescrito em relação ao v6: há uma instância, áreas ligadas a ela e interface-templates que dizem quais interfaces ou redes entram em cada área. No cenário, o BNG é um Mikrotik que participa do OSPF no provedor com dois enlaces de 10G no anel. A sintaxe abaixo segue a referência de CLI do manual da MikroTik para o v7.
/ip/address
add address=198.51.100.4/32 interface=lo
/routing/ospf/instance
add name=backbone version=2 router-id=198.51.100.4
/routing/ospf/area
add name=area0 area-id=0.0.0.0 instance=backbone
/routing/ospf/interface-template
add area=area0 networks=198.51.100.4/32 passive
add area=area0 interfaces=sfp-sfpplus1,sfp-sfpplus2 type=ptp cost=10 \
    auth=md5 auth-id=1 auth-key=Troque-Esta-Chave use-bfd=yes
/routing/bfd/configuration
add interfaces=sfp-sfpplus1,sfp-sfpplus2interface=lo: a loopback do RouterOS v7, que recebe a /32.router-idna instância com o IP da loopback, pelo mesmo motivo do Huawei.- O primeiro template coloca a /32 na área 0 como
passive: a rede é anunciada e nenhum pacote OSPF sai por ali. - O segundo template cobre os dois enlaces:
type=ptp,cost=10fixo, MD5 comauth-id=1e a mesma chave do Huawei, euse-bfd=yes. /routing/bfd/configuration: no v7, o BFD só roda nas interfaces liberadas nesse menu. Sem essa linha, ouse-bfd=yesnão cria sessão nenhuma.
Para conferir, liste os vizinhos, as interfaces que o template ativou e as sessões BFD:
/routing/ospf/neighbor print
/routing/ospf/interface print
/routing/bfd/session print
Se o vizinho não aparece, confira primeiro se o template casou com a interface certa no /routing/ospf/interface print. Interface que não está ali não fala OSPF, por mais que o resto pareça certo.
Como verificar o OSPF no provedor
Depois de cada mudança, quatro comandos no Huawei mostram se o OSPF no provedor está como você planejou: vizinhos, interfaces com tipo e custo, rotas aprendidas e sessões BFD.
display ospf peer brief
display ospf interface
display ip routing-table protocol ospf
display ospf bfd session all
Na BORDA, a saída esperada do primeiro comando é esta, com os dois vizinhos em Full:
          OSPF Process 1 with Router ID 198.51.100.1
                  Peer Statistic Information
 ---------------------------------------------------------------------
 Area Id          Interface                  Neighbor id      State
 0.0.0.0          GigabitEthernet0/1/0       198.51.100.2     Full
 0.0.0.0          GigabitEthernet0/1/1       198.51.100.3     Full
 ---------------------------------------------------------------------
E as rotas OSPF confirmam o custo planejado. A AGREG aparece com custo 30 pelo anel, e não com 100 pelo enlace direto:
Destination/Mask  Proto  Pre  Cost  Flags NextHop       Interface
  198.51.100.2/32  OSPF   10   10      D   203.0.113.2   GE0/1/0
  198.51.100.4/32  OSPF   10   20      D   203.0.113.2   GE0/1/0
  198.51.100.3/32  OSPF   10   30      D   203.0.113.2   GE0/1/0
    203.0.113.4/30  OSPF   10   20      D   203.0.113.2   GE0/1/0
    203.0.113.8/30  OSPF   10   30      D   203.0.113.2   GE0/1/0
Se uma loopback aparecer com máscara diferente de /32, ou se aparecerem redes de cliente nessa tabela, corrija antes de subir iBGP ou MPLS por cima. O mesmo backbone vai carregar o LDP e, depois, serviços como a L3VPN MPLS no Huawei.
Erros comuns de OSPF no provedor
| Sintoma | Causa provável | O que fazer |
|---|---|---|
| Vizinho preso em ExStart ou Exchange | MTU diferente nas pontas | Mesmo MTU nos dois lados do enlace |
| Vizinho em Full, mas faltam rotas pelo enlace | network-type diferente nas pontas | p2p nos dois lados e conferir com display ospf interface |
| Vizinho nunca aparece | Autenticação, área ou template errado | Conferir key-id, chave e área nas duas pontas |
| Tráfego indo pelo enlace de reserva | Custo igual em 1G e 10G | bandwidth-reference igual em todos ou custo fixo |
| Router-id duplicado nos logs | Configuração copiada de outro roteador | Router-id = loopback de cada equipamento |
| SPF rodando o tempo todo | Pool de cliente ou rede instável no OSPF | Tirar do IGP e anunciar por BGP |
No Huawei, a checagem de MTU nos pacotes DD vem desligada por padrão e é ligada com ospf mtu-enable na interface. Por isso o ExStart por MTU aparece mais no enlace com outro fabricante, como o Mikrotik.
O caso do router-id duplicado aparece mais do que deveria: alguém copia a configuração de um POP para outro, troca os IPs das interfaces e esquece a linha do processo. Os dois roteadores brigam pelo mesmo identificador e as rotas ficam instáveis. Uma checagem rápida antes do commit evita a janela de manutenção perdida.
Perguntas frequentes
Posso colocar o pool de PPPoE no OSPF?
Funciona, mas não é o recomendado. O pool muda com o tempo, aumenta a base de estados de enlace e expõe o backbone a erros de cada concentrador. Anuncie o pool por BGP a partir do BNG, com next-hop na loopback dele.
Preciso de mais de uma área para o OSPF no provedor?
Na maioria dos provedores regionais, não. Uma área 0 bem cuidada aguenta dezenas de roteadores. Divida só quando houver motivo medido, como base grande demais para os equipamentos menores.
Qual valor usar no bandwidth-reference?
Um valor acima da maior banda da sua rede, igual em todos os roteadores. Com 100000 (100 Gbit/s), 10G fica com custo 10 e 1G com custo 100. Se a rede já tem enlaces de 100G agregados, considere um valor maior.
OSPF ou IS-IS no backbone do provedor?
Os dois resolvem o mesmo problema. O OSPF é mais conhecido e roda em qualquer equipamento; o IS-IS é preferido por muitos provedores maiores porque não depende do IP para trocar as próprias mensagens e leva IPv6 no mesmo processo. O que importa mais é manter o IGP enxuto.
O BFD substitui os timers de hello e dead do OSPF?
Não substitui, complementa. O OSPF continua com hello e dead interval, e o BFD avisa a queda antes. Ajustar só os timers do OSPF para valores muito baixos pesa mais na CPU do que usar BFD.
Conclusão
Um OSPF no provedor bem feito é quase entediante: loopbacks /32, enlaces ponto a ponto, uma área, custos planejados, autenticação e BFD. Toda a complexidade de cliente, trânsito e política fica no BGP, onde ela tem ferramenta própria. Quando um enlace cai, o IGP converge rápido e só as loopbacks mudam de caminho.
Se a sua rede já tem pool e rede de cliente no OSPF, a migração pode ser feita aos poucos: anuncie o prefixo pelo BGP, confira que a rota chega a todos e só então tire do IGP. Depois disso, o próximo passo natural é subir o MPLS por cima desse backbone, tema do guia sobre o que é MPLS.
Leitura recomendada: Boas práticas para a implantação do OSPF em ambientes de ISP, no wiki do Brasil Peering Forum (CC BY-NC 4.0).

Leia Também
 Dicas
IPv6 link-local: acessar equipamento sem IP configurado
IPv6 link-local na bancada: ache o equipamento com ping ff02::1, entre por SSH ou Winbox em fe80 no Linux e no Windows, mesmo sem IPv4 de gerência.
 Dicas
Segurança no Mikrotik RouterOS v7: hardening passo a passo
Segurança no Mikrotik RouterOS v7: usuários, serviços, MAC server, firewall input com address-list, SSH com chave, atualização e backup.
 Dicas
CGNAT: o que é e como funciona no provedor de internet
CGNAT: o que é, por que o cliente fica sem IP público, como o provedor divide portas na faixa 100.64.0.0/10, impactos e guarda de logs.