
DNS anycast com BGP e FRR: recursivo resiliente em dois nós

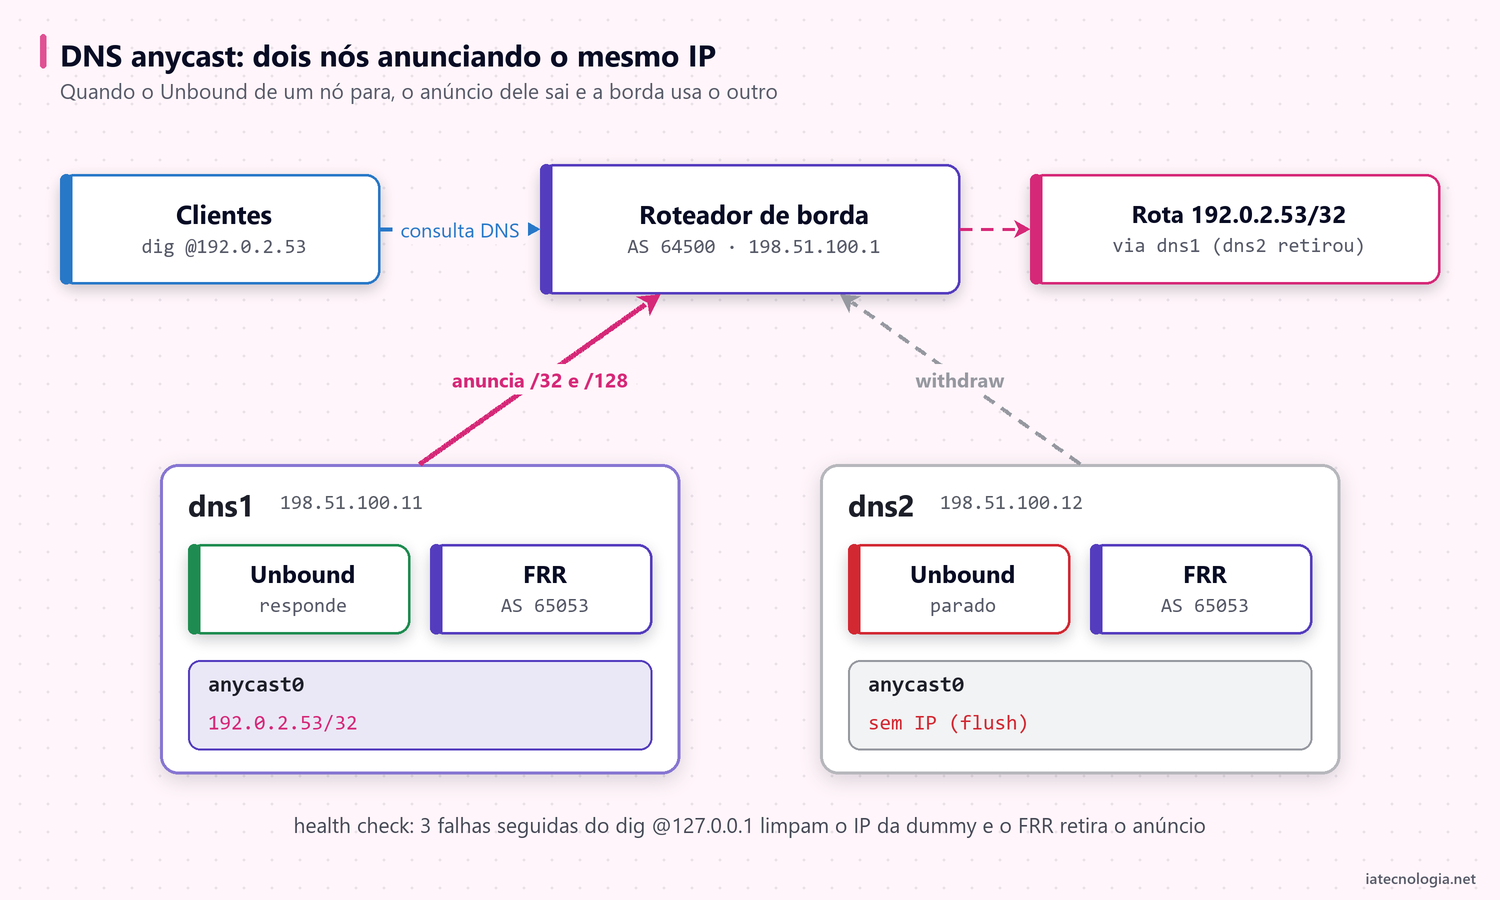
Todo provedor entrega dois IPs de DNS para o cliente, e quase todo cliente usa só o primeiro. Quando o servidor desse IP para, a navegação para junto, mesmo com o segundo servidor de pé. O DNS anycast resolve isso pelo lado da rede: o mesmo IP de serviço fica configurado em dois servidores, os dois anunciam esse IP por BGP e, se um falha, o anúncio dele sai e o tráfego vai para o outro sem o cliente perceber.
Este guia monta isso em laboratório com dois nós Debian, Unbound como recursivo e FRR falando BGP com o roteador de borda. O foco é a parte que costuma faltar nos tutoriais: o health check que tira o anúncio quando o Unbound para. A instalação e o ajuste do recursivo em si estão no post sobre DNS recursivo com Unbound para provedor. Os endereços e ASNs são de documentação.
Resposta rápida: DNS anycast em dois nós
- Escolha um IP de serviço, por exemplo 192.0.2.53/32 e 2001:db8:53::53/128.
- Configure o Unbound nos dois nós para ouvir nesse IP, com
ip-transparent: yes. - Coloque o IP numa interface dummy, a
anycast0. - No FRR, anuncie o /32 e o /128 para a borda com
network, filtro de saída e filtro de entrada que não aceita nada. - Rode um health check que consulta o Unbound local e remove o IP da dummy quando ele não responde. Sem o IP, o FRR retira o anúncio sozinho.
- Teste parando o Unbound de um nó e consultando
id.serverpelo cliente.
Como o DNS anycast funciona
Anycast é anunciar o mesmo prefixo a partir de mais de um lugar. Os roteadores escolhem o caminho como sempre fazem, pela melhor rota, e cada pacote chega ao nó que estiver mais perto segundo o BGP. Para o cliente, existe um único servidor no 192.0.2.53. Para a rede, existem dois.
DNS recursivo combina bem com isso. A consulta típica é um pacote UDP de ida e outro de volta, sem sessão longa para manter. Se o caminho muda no meio do dia, a próxima consulta vai para o outro nó e pronto. Consultas TCP também funcionam, porque a rota não muda a cada pacote, só quando um nó entra ou sai.
A peça que faz a falha funcionar é o anúncio. Enquanto o nó anuncia o /32, ele recebe tráfego. Quando para de anunciar, a borda tira a rota e o tráfego vai para quem sobrou. Se o BGP ainda é novidade para você, leia antes sobre o que é BGP e como ele funciona.
Anycast não é balanceamento de carga
Com dois nós na mesma borda, a borda escolhe um melhor caminho e manda tudo para ele. O outro fica de reserva. Para dividir o tráfego, a borda precisa de multipath (ECMP) habilitado para esse prefixo, e a divisão passa a ser por fluxo. Nos dois casos o DNS anycast já resolve o que importa aqui, que é sobreviver à queda de um servidor.
O cenário do laboratório de DNS anycast
Os dois nós ficam na mesma VLAN de servidores que a borda, cada um com o seu IP fixo, e falam eBGP com a borda usando um ASN privado. O IP de serviço do DNS anycast não aparece em interface física nenhuma: ele mora numa interface dummy e só existe na rede enquanto é anunciado.
| Equipamento | IPv4 | IPv6 | Observação |
|---|---|---|---|
| Borda | 198.51.100.1 | 2001:db8:100::1 | AS 64500 |
| dns1 | 198.51.100.11 | 2001:db8:100::11 | AS 65053 |
| dns2 | 198.51.100.12 | 2001:db8:100::12 | AS 65053 |
| IP de serviço (anycast) | 192.0.2.53/32 | 2001:db8:53::53/128 | nos dois nós |
| Clientes | 203.0.113.0/24 e 100.64.0.0/10 | 2001:db8:1000::/36 | acesso liberado no Unbound |
O IPv6 segue exatamente o mesmo desenho. Se o seu provedor já entrega IPv6 para os clientes, o recursivo precisa responder pelos dois protocolos, e o anúncio do /128 vai junto com o do /32.
Passo 1: o Unbound ouvindo no IP anycast
Nos dois nós, instale os pacotes. O dnsutils traz o dig, que o health check usa:
apt install unbound frr dnsutils
Depois, um arquivo próprio para o anycast dentro de unbound.conf.d:
# /etc/unbound/unbound.conf.d/anycast.conf
server:
    interface: 127.0.0.1
    interface: ::1
    interface: 192.0.2.53
    interface: 2001:db8:53::53
    ip-transparent: yes
    do-ip6: yes
    identity: "dns1"
    access-control: 203.0.113.0/24 allow
    access-control: 100.64.0.0/10 allow
access-control: 2001:db8:1000::/36 allow- interface: sem nenhuma linha
interface, o Unbound ouve só em localhost. Aqui ele ouve em localhost (para o health check) e nos dois IPs de serviço. - ip-transparent: yes: deixa o Unbound abrir o socket num endereço que ainda não existe na máquina. É o que permite ao health check tirar e devolver o IP sem reiniciar o Unbound.
- do-ip6: yes: responde e consulta por IPv6.
- identity: o nome devolvido na consulta
id.server. No dns2, troque para"dns2". É assim que você descobre qual nó respondeu. - access-control: por padrão só localhost (127.0.0.0/8 e ::1) é liberado e o resto é recusado. Libere as redes dos seus clientes, e nada além disso. Recursivo aberto vira amplificador de ataque.
Confira a sintaxe antes de reiniciar:
unbound-checkconf
systemctl restart unbound
Passo 2: a interface dummy com o IP de serviço
Uma interface dummy é uma interface virtual que existe só dentro do Linux. Ela serve bem para o IP anycast por um motivo prático: o IP fica isolado, longe do lo e da interface física, e tirar ou pôr o endereço não mexe em mais nada. Para o primeiro teste, crie na mão:
ip link add anycast0 type dummy
ip link set anycast0 up
ip addr add 192.0.2.53/32 dev anycast0
ip -6 addr add 2001:db8:53::53/128 dev anycast0 nodad
ip addr show dev anycast0
O nodad no IPv6 desliga a detecção de endereço duplicado para esse endereço. Sem ele, o endereço passa alguns instantes em estado tentativo antes de ficar utilizável. Mais adiante, o health check passa a criar a interface e a gerenciar os endereços, então esses comandos não vão para nenhum arquivo de boot.
Passo 3: o FRR anunciando o /32 e o /128
Habilite o daemon de BGP no arquivo de daemons do FRR:
# /etc/frr/daemons
bgpd=yes
E a configuração do dns1. No dns2 mudam só o hostname e o bgp router-id:
! /etc/frr/frr.conf (dns1)
hostname dns1
!
ip prefix-list ANYCAST4 seq 10 permit 192.0.2.53/32
ipv6 prefix-list ANYCAST6 seq 10 permit 2001:db8:53::53/128
!
route-map ANYCAST4-OUT permit 10
 match ip address prefix-list ANYCAST4
!
route-map ANYCAST6-OUT permit 10
 match ipv6 address prefix-list ANYCAST6
!
route-map NADA-IN deny 10
!
router bgp 65053
 bgp router-id 198.51.100.11
 no bgp default ipv4-unicast
 neighbor 198.51.100.1 remote-as 64500
 neighbor 198.51.100.1 description borda-v4
 neighbor 2001:db8:100::1 remote-as 64500
 neighbor 2001:db8:100::1 description borda-v6
 !
 address-family ipv4 unicast
  network 192.0.2.53/32
  neighbor 198.51.100.1 activate
  neighbor 198.51.100.1 route-map NADA-IN in
  neighbor 198.51.100.1 route-map ANYCAST4-OUT out
 exit-address-family
 !
 address-family ipv6 unicast
  network 2001:db8:53::53/128
  neighbor 2001:db8:100::1 activate
  neighbor 2001:db8:100::1 route-map NADA-IN in
  neighbor 2001:db8:100::1 route-map ANYCAST6-OUT out
 exit-address-family
O que cada parte faz:
- prefix-list ANYCAST4 e ANYCAST6: casam só com o IP de serviço. É o que o nó tem permissão para anunciar.
- route-map ANYCAST4-OUT e ANYCAST6-OUT: filtro de saída. Mesmo que alguém acrescente outra rede no BGP por engano, ela não sai do nó.
- route-map NADA-IN: uma única entrada
denysemmatch, que recusa tudo o que a borda mandar. O nó de DNS não precisa de rota BGP nenhuma, ele usa o gateway padrão. - no bgp default ipv4-unicast: sem isso, o vizinho IPv6 também seria ativado para IPv4. Com ela, cada vizinho só entra no address-family onde aparece o
activate. - network: anuncia o prefixo só se ele existir na tabela de rotas. Esse é o comportamento padrão do FRR (
bgp network import-check). É ele que liga o anúncio ao IP da dummy: sem o IP, a rota conectada some e o anúncio sai.
bgp ebgp-requires-policy vem ligada (RFC 8212): sessão eBGP sem route-map de entrada e de saída não troca rota. É um erro comum ver a sessão estabelecida e nada sendo anunciado.Reinicie e confira a sessão e o que está saindo para a borda:
systemctl restart frr
vtysh -c 'show bgp summary'
vtysh -c 'show bgp ipv4 unicast neighbors 198.51.100.1 advertised-routes'
vtysh -c 'show bgp ipv6 unicast neighbors 2001:db8:100::1 advertised-routes'
Na saída do advertised-routes tem de aparecer só o 192.0.2.53/32 no IPv4 e só o 2001:db8:53::53/128 no IPv6.
Passo 4: o health check que retira o anúncio
Sem health check, o DNS anycast cobre só a queda do servidor inteiro. Se o Unbound travar e o Linux continuar de pé, o FRR segue anunciando e o tráfego cai num nó que não responde. O script abaixo resolve isso tirando o IP da dummy quando o Unbound não responde:
#!/bin/sh
# /usr/local/sbin/anycast-check
# Mantém o IP anycast só enquanto o Unbound local responde.
IF=anycast0
V4=192.0.2.53
V6=2001:db8:53::53
OK=0
FAIL=0
ip link show "$IF" >/dev/null 2>&1 || ip link add "$IF" type dummy
ip link set "$IF" up
while true; do
  R=$(dig @127.0.0.1 . SOA +short +time=1 +tries=1 2>/dev/null)
  if [ -n "$R" ]; then OK=$((OK+1)); FAIL=0
  else FAIL=$((FAIL+1)); OK=0; fi
  if [ "$OK" -ge 3 ] && ! ip -4 addr show dev "$IF" | grep -q "$V4"
  then
    ip addr add "$V4/32" dev "$IF"
    ip -6 addr add "$V6/128" dev "$IF" nodad
    logger -t anycast "unbound ok: anunciando $V4 e $V6"
  fi
  if [ "$FAIL" -ge 3 ] && ip -4 addr show dev "$IF" | grep -q "$V4"
  then
    ip addr flush dev "$IF"
    logger -t anycast "unbound falhou: retirando o anuncio"
  fi
  sleep 2
done
Linha por linha, o que importa:
- O
digconsulta o SOA da raiz no Unbound local, com timeout de 1 segundo e uma tentativa. Resposta vazia (Unbound parado, travado ou sem responder) conta como falha. - São precisas três falhas seguidas para retirar e três sucessos seguidos para devolver. Isso evita que um pacote perdido faça o anúncio piscar.
- O
grepconfere se o IP já está na interface antes de agir. Assim o script não mexe na interface a cada volta, e o FRR não recebe eventos à toa. - Para retirar, o
ip addr flushlimpa os endereços da dummy. A rota conectada some, onetworkdeixa de valer e o FRR manda o withdraw. - O
loggergrava cada mudança no journal com a taganycast.
Com o laço de 2 segundos e o timeout de 1, o nó sai do ar entre 4 e 9 segundos depois de o Unbound parar de responder: mais perto de 4 quando o processo morre, mais perto de 9 quando ele trava sem responder. Para rodar como serviço:
# /etc/systemd/system/anycast-check.service
[Unit]
Description=Health check do DNS anycast
After=network-online.target unbound.service frr.service
Wants=network-online.target

[Service]
ExecStart=/usr/local/sbin/anycast-check
ExecStopPost=-ip addr flush dev anycast0
Restart=always
RestartSec=2

[Install]
WantedBy=multi-user.target
chmod +x /usr/local/sbin/anycast-check
systemctl daemon-reload
systemctl enable --now anycast-check
journalctl -t anycast -f
O ExecStopPost limpa os endereços quando o serviço para por qualquer motivo. Isso protege contra o pior caso: o health check morre e deixa o IP configurado, anunciando um nó que ninguém está vigiando.
O que configurar no roteador de borda
A borda é a outra metade do DNS anycast, e os comandos mudam conforme o fabricante. Os pontos que valem para qualquer um:
- Aceite dos dois nós apenas 192.0.2.53/32 e 2001:db8:53::53/128. Um erro de configuração num servidor não pode virar rota na sua rede.
- Ponha um limite de prefixos baixo na sessão, como 2 ou 5, para derrubar a sessão se o nó anunciar algo estranho.
- Decida se quer multipath para dividir o tráfego entre os nós ou um ativo e outro reserva.
- Não exporte os /32 e /128 para trânsitos e IX. Eles são internos, e a maioria das redes nem aceitaria um prefixo desse tamanho.
Se a borda redistribui essas rotas no IGP ou no iBGP para outros roteadores, cada POP passa a mandar as consultas para o nó mais próximo dele. É assim que o desenho cresce de dois nós num lugar só para nós espalhados pela rede.
Testes de falha do DNS anycast
Antes de pôr cliente em cima, quebre o laboratório de propósito. Primeiro, de uma máquina na rede de clientes, descubra quem está respondendo:
dig @192.0.2.53 id.server CH TXT +short
dig @2001:db8:53::53 id.server CH TXT +short
dig @192.0.2.53 registro.br +dnssec
"dns1"
A primeira linha responde o identity configurado no nó que atendeu. A última confere que o recursivo está resolvendo e validando DNSSEC, com a flag ad na resposta. Agora, no nó que respondeu, pare o Unbound:
systemctl stop unbound
journalctl -t anycast -n 5
vtysh -c 'show bgp ipv4 unicast neighbors 198.51.100.1 advertised-routes'
systemctl start unbound
anycast: unbound falhou: retirando o anuncio
anycast: unbound ok: anunciando 192.0.2.53 e 2001:db8:53::53
O advertised-routes volta vazio, e o dig do cliente passa a responder "dns2". Ao subir o Unbound de novo, depois de três verificações boas o IP volta, o anúncio volta e o log mostra a segunda linha. Repita o teste parando o FRR e desligando o servidor, e anote quanto tempo cada caso leva.
| Falha | O que acontece | Tempo até o tráfego mudar |
|---|---|---|
| Unbound parado ou travado | Health check falha 3 vezes e limpa o IP | Entre 4 e 9 segundos |
| Serviço anycast-check parado | ExecStopPost limpa o IP | Imediato |
| FRR parado | A sessão BGP cai e a borda remove as rotas do nó | Imediato se a sessão fecha; senão o hold time |
| Servidor desligado ou travado | A borda só percebe pelo hold time do BGP | O hold time configurado |
| Cabo ou porta da borda | A sessão cai quando a borda detecta a queda do enlace | Depende da borda |
O ponto fraco da tabela é o servidor que trava por inteiro. Nesse caso nada no nó consegue avisar, e quem percebe é o BGP pelo hold time. Para encurtar esse tempo, use BFD entre o nó e a borda ou timers de BGP menores, conforme a documentação do FRR e da sua borda.
Manutenção sem derrubar cliente
Para atualizar ou reiniciar um nó, tire ele do anycast antes:
systemctl stop anycast-check
ip addr show dev anycast0
systemctl start anycast-check
Com o serviço parado, o IP sai da dummy e o tráfego vai para o outro nó. Faça a manutenção e suba o serviço de novo. O IP volta assim que o Unbound responder três vezes.
Erros comuns em DNS anycast
- Sessão estabelecida e nada anunciado. Faltou route-map de entrada ou de saída (
ebgp-requires-policy) ou o IP não está na dummy (networksem rota). - Unbound não sobe depois do reboot. Faltou
ip-transparent: yes, e o IP ainda não existe quando o Unbound tenta abrir o socket. - Cliente recebe REFUSED. A rede dele não está no
access-control. Lembre da faixa de CGNAT e do bloco IPv6. - Health check que só confere o processo.
systemctl is-activediz que o Unbound existe, não que ele responde. Consulte de verdade. - Mesmo identity nos dois nós. O teste com
id.serverdeixa de dizer quem respondeu. - Anúncio vazando para fora. Os /32 e /128 do anycast precisam de filtro de saída na borda para trânsitos e IX.
Perguntas frequentes
Preciso de ASN público para fazer DNS anycast?
Não. O anycast deste guia é interno: os nós falam com a sua borda usando um ASN privado, e o IP de serviço sai de um bloco que você já tem. Só faria sentido ASN e prefixo próprios se o anycast fosse anunciado para a internet, o que não é o caso de um recursivo para clientes.
Posso usar o mesmo IP anycast como primário e secundário?
Pode, mas é melhor ter dois IPs de serviço, os dois em anycast. Alguns sistemas só passam a usar o secundário quando o primário falha, e dois endereços distintos dão ao cliente uma segunda chance caso algo dê errado com a rota de um deles.
O cache se perde quando o tráfego muda de nó?
Cada nó do DNS anycast tem o seu próprio cache. Quando o tráfego muda, o nó que assume já tem cache próprio se estava atendendo alguém, ou começa frio se estava parado. O efeito são algumas dezenas de milissegundos a mais na primeira consulta de cada nome, até o cache esquentar. O cliente dificilmente percebe.
Dá para fazer com BIRD em vez de FRR?
Dá. A lógica é a mesma: anunciar o /32 e o /128 só enquanto o IP existir na interface e filtrar nos dois sentidos. Muda a sintaxe da configuração. Este guia usa FRR porque a configuração dele é próxima da de roteadores e mais fácil de ler para quem vem de Cisco ou Huawei.
Quantos nós de DNS anycast eu preciso?
Dois já resolvem a queda de um servidor. A partir daí, o número acompanha a rede: um par por região ou por POP grande deixa a consulta perto do cliente e evita que a queda de um enlace mande todo o DNS por um caminho longo.
Conclusão
O DNS anycast tira o recursivo da lista de pontos únicos de falha com pouca peça: um IP numa interface dummy, o Unbound ouvindo nele com ip-transparent, o FRR anunciando com network e filtros nos dois sentidos, e um health check que limpa o IP quando o Unbound não responde. O BGP faz o resto.
O que separa um laboratório de uma rede de produção são os testes: parar o Unbound, parar o FRR, desligar o nó e medir quanto tempo cada caso leva. Com esses números na mão, você sabe exatamente o que o cliente vai sentir na próxima falha.
Leitura recomendada: Melhorando a performance e resiliência da rede com Recursive DNS Anycast, na wiki do Brasil Peering Forum (CC BY-NC 4.0).

Leia Também
 Linux
Portas de amplificação DDoS: o que o provedor deve filtrar
Portas de amplificação DDoS: como funciona o ataque por reflexão, quais serviços UDP fechar, como achar clientes refletores e filtrar no provedor.
 Linux
Zabbix e Grafana: dashboard de tráfego para provedor
Zabbix e Grafana no provedor: plugin Zabbix, datasource com token de API, variáveis por host e painéis de trânsito, CPU e PON para o NOC.
 GPON
Netmiko com Python: automação de OLT Huawei via SSH
Netmiko com Python na OLT Huawei MA5800: device_type certo, paginação, prompts, coleta do display ont info, parser e várias OLTs sem estourar o VTY.